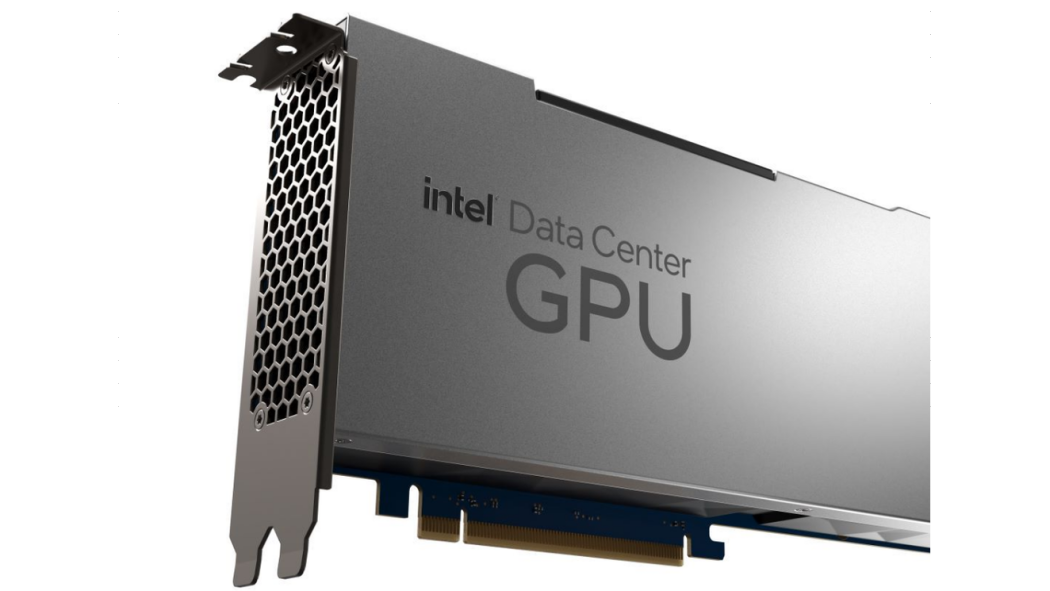
GPU加速器是一種利用圖形處理器的高性能計算能力來提升數據處理速度的專用硬體,主要套用於數據中心及雲計算領域。其核心硬體採用多核處理器與多執行緒技術最佳化並行計算,並配備HBM或GDDR等先進顯存以提升數據傳輸性能。硬體支持HBM4規範的記憶體接口及兼容UCIe 2.0規範的3D封裝技術,通過PCIe 7.0接口提供高頻寬,並適配NVMe 2.1存儲協定。作為AI伺服器的關鍵組件,專為深度學習計算設計的加速卡在算力、記憶體頻寬等關鍵指標上遠超普通顯示卡。代表性產品如採用Hopper架構的NVIDIAH100,以及採用CDNA 3架構的AMDInstinct MI300系列加速器。全球GPU加速器市場主要由AMD、NVIDIA等廠商主導。
基本介紹
- 中文名:GPU加速器
- 類型:加速器
- 用途:數據中心及雲計算
定義與概述,發展歷程,工作原理與架構,核心技術與標準,高頻寬記憶體技術,高速互連技術,先進封裝技術,專用計算架構,存儲協定,虛擬化與資源管理技術,硬體設計標準,技術參數與性能,套用場景,市場與產業現狀,相關事件,
定義與概述
GPU加速器是一種專門用於加速圖形處理和計算任務的硬體設備,基於圖形處理器(GPU)的架構,具有高度並行的計算能力和大規模的記憶體頻寬。其核心任務是讓AI模型訓練得更快、推理更高效,擅長處理海量數據、矩陣運算等AI任務。GPU加速器(或加速卡)主要由GPU晶片、記憶體晶片、電源模組、散熱器等部件組成,通過PCB連線。它利用GPU(圖形處理器)的高性能計算能力提升數據處理速度,主要套用於數據中心及雲計算領域,為企業提供高效計算服務,套用場景涵蓋AI模型訓練與推理、高性能計算(HPC)、大數據分析及圖形渲染等。
發展歷程
早期數據中心GPU加速器以NVIDIA Tesla K80為代表,該加速器採用雙GPU設計,旨在提升實際應用程式的吞吐量。2016年左右,基於Pascal架構的NVIDIA Tesla P100作為較早的AI超級計算數據中心GPU之一,引入了NVLink和HBM2技術。2017年,基於Volta架構的V100 Tensor Core GPU實現了超過100萬億次的深度學習性能。2020年,採用Ampere架構的NVIDIA A100 GPU提升了AI、HPC和圖形工作負載的處理能力。2022年及之後,基於Hopper架構的NVIDIA H100 GPU系列發布,該系列是具備機密計算功能的GPU加速器,支持PCIe 5.0和HBM3顯存,並引入了Transformer引擎等新技術。
AMD推出了Instinct MI系列加速器,其MI250X套用於超算Frontier。2023年,AMD發布Instinct MI300系列AI加速器,其中MI300X基於全新AMD CDNA 3架構,整合5納米與6納米製程生產的小晶片,利用3D封裝技術,配備192GB HBM3記憶體容量。
海光DCU K100_AI、寒武紀MLU370-M8、沐曦C500、摩爾執行緒S4000和燧原S60等國產AI加速卡產品進入市場。
2025年以來,中科曙光近期3套scaleX萬卡超集群支撐建設國家超算網際網路核心節點,這一總規模超3萬張國產AI加速卡的算力池是規模較大的國產AI算力池。scaleX萬卡超集群基於AI計算開放架構,全面兼容CUDA等主流軟體生態,支持多品牌國產加速卡混合部署。
工作原理與架構
GPU加速器利用GPU(圖形處理器)的高性能計算能力提升數據處理速度,其核心是利用大規模並行計算單元(如CUDA核心、Tensor Core)處理計算密集型任務。該設備採用多核處理器與多執行緒技術最佳化並行計算效率。硬體上主要分為SXM版本和PCIe版本兩種類型,SXM版本相比PCIe版本具有更高的頻寬和更低的延遲,但也需要更高級別的PCB和散熱系統。
GPU加速卡主要由GPU晶片、記憶體晶片、電源模組、散熱器等部件組成,通過PCB來連線和傳輸信號。核心組件包括GPU計算核心(如CUDA核心、Tensor Core)、高頻寬記憶體(HBM/GDDR)、高速互連技術(如NVLink、PCIe)、電源模組和散熱系統。PCB(印製電路板)是連線各部件的基礎,對製造工藝要求非常高,需要滿足高速信號傳輸、高可靠性和熱穩定性。
GPU加速器的架構不斷演進,例如NVIDIA的Ampere、Hopper、Blackwell架構和AMD的CDNA架構。硬體支持HBM4規範的記憶體接口寬度及兼容UCIe 2.0規範的3D封裝技術,實現高頻寬低延遲的異構晶片通信。通過PCIe 7.0接口提供512 GB/s雙向頻寬,適配NVMe 2.1存儲協定以保障數據供給效率。
核心技術與標準
支撐GPU加速器性能的關鍵底層技術和行業標準包括高頻寬記憶體、高速互連、先進封裝、專用計算架構、存儲協定、虛擬化與資源管理以及硬體設計規範等。
高頻寬記憶體技術
高頻寬記憶體(HBM)是提升GPU加速器數據吞吐量的關鍵技術。最新的HBM3標準提供了極高的記憶體頻寬,如NVIDIA V100 GPU的HBM2頻寬達900GB/s。JEDEC固態技術協會發布的HBM4初步規範將進一步增加記憶體接口寬度,從每堆疊1024位增加到2048位,並預計將堆疊層數從現有的8層/12層發展到16層垂直堆疊。
高速互連技術
GPU加速器間的互聯頻寬對集群性能至關重要。NVIDIA NVLink技術提供遠超PCIe的GPU間互聯頻寬,如V100 GPU的NVLink頻寬達300GB/s,Tesla P100的NVLink頻寬為160 GB/s。PCIe 7.0草案每pin數據傳輸速率達128GT/s,通過x16配置可提供高達512 GB/s的雙向頻寬。
先進封裝技術
為提升集成密度和性能,GPU加速器廣泛採用2.5D和3D封裝技術。例如,Tesla P100採用了採用HBM2的CoWoS封裝技術。通用芯粒互連(UCIe)產業聯盟發布的UCIe 2.0規範著重最佳化了3D封裝技術,可縮短芯粒間的距離,提高集成密度和信號傳輸速度。
專用計算架構
為最佳化特定計算負載,GPU加速器集成了專用計算核心。例如,NVIDIA的Tensor Core(張量核心)針對AI矩陣運算進行了深度最佳化。其Hopper架構(如H100 GPU)還引入了Transformer引擎,專門針對大語言模型的訓練與推理進行最佳化。
存儲協定
高效的存儲訪問協定對數據處理流水線至關重要。NVM Express組織發布的NVMe 2.1規範最佳化了存儲設備的性能,提升了數據存儲與訪問效率。該規範支持主機管理加密、任務卸載(offloading)等功能,增強了數據安全保護。
虛擬化與資源管理技術
為提高數據中心GPU資源的利用率和隔離性,出現了多實例GPU(MIG)技術。該技術可將單個物理GPU劃分為多個獨立實例,每個實例具備獨立的計算和記憶體資源。NVIDIA H100 GPU採用了第二代MIG技術。
硬體設計標準
GPU加速卡的硬體設計遵循高標準以滿足高性能和可靠性要求。主要分為SXM和PCIe兩種接口形態,SXM版本相比PCIe版本具有更高的頻寬和更低的延遲。其印刷電路板(PCB)通常採用高階高密度互連(HDI)技術,層數可達20-26層,並需選用具有低介電損耗、高導熱係數等特性的高速板材。
技術參數與性能
評估和選型GPU加速器時需關注核心硬體參數及其意義,主要包括核心算力指標、顯存配置、互聯頻寬、功耗與能效以及核心架構等。
核心算力指標主要指浮點計算能力,以TFLOPS為單位衡量,不同精度類型適用於不同場景。例如,NVIDIA V100提供雙精度7.8 TFLOPS、單精度15.7 TFLOPS及深度學習125 TFLOPS的算力;Tesla P100提供雙精度4.7/5.3 teraFLOPS、單精度9.3/10.6 teraFLOPS、半精度18.7/21.2 teraFLOPS的算力;NVIDIA A100為雙精度提供高達19.5 TFLOPS的浮點運算能力,為單精度提供高達39.5 TFLOPS的浮點運算能力,張量核心可為FP16精度提供高達312 TFLOPS的性能。
顯存配置包括顯存容量、類型和頻寬,是影響AI計算性能的關鍵瓶頸之一。NVIDIA Tesla K80配備24 GB的GDDR5顯存,總顯存頻寬為480 GB/s。NVIDIA V100提供32/16GB HBM2顯存,頻寬為900GB/s。NVIDIA H100搭載HBM3顯存,實現3TB/s的顯存頻寬。AMD Instinct MI300X配備192GB HBM3記憶體,頻寬達到5.2TB/s。技術趨勢方面,HBM4將增加記憶體接口寬度至2048位,並預計堆疊技術將發展到16層垂直堆疊。
互聯頻寬區分GPU間互聯和與主機互聯。NVIDIA V100的NVLink互聯頻寬為300GB/s,PCIe頻寬為32GB/s。Tesla P100的NVLink互聯頻寬為160 GB/s。PCIe 7.0標準通過x16配置可以提供高達512 GB/s的雙向頻寬。
功耗與能效方面,熱設計功耗(TDP)和能耗比(TFLOPS/W)是重要考量指標。NVIDIA V100的最大功耗為300瓦特。NVIDIA A100與H100在TDP及能效上存在差異,H100 GPU比A100 GPU更節能。
核心架構與數量包括核心數量(如CUDA核心、Tensor Core)和製造工藝。Tesla K80具有4992個NVIDIA CUDA核心。V100擁有640個Tensor核心。A100集成了第三代Tensor Core,H100具有新的第四代Tensor Core和Transformer引擎。H100採用台積電4N工藝,有800億個電晶體。
選型需根據模型規模、套用場景(訓練/推理/HPC)和預算綜合決策。不同架構產品定位存在差異,例如英偉達的Ada架構主要為消費級市場設計,Hopper架構系列是AI訓練的標桿,Blackwell架構專為千億至萬億參數大模型的高效訓練設計,Rubin架構為超大規模AI推理和長序列處理提供支持。
套用場景
GPU加速器在人工智慧與機器學習領域套用於大規模語言模型訓練與推理、計算機視覺、自然語言處理等場景,並能提升推理速度、降低延遲。在高性能計算領域,超過550款行業領先的應用程式支持GPU加速器,涵蓋全部名列前位的HPC應用程式,其設計能夠融合人工智慧和高性能計算。
在圖形處理與渲染領域,GPU加速器用於雲端圖形工作站,以運行實時渲染、產品設計、工程仿真和內容創建等工作負載。在數據中心與雲計算領域,全球各大主要雲服務提供商均提供由GPU加速器助力的解決方案,GPU雲伺服器主要套用於視頻編解碼、深度學習、科學計算等場景。
市場與產業現狀
GPU加速器市場在全球人工智慧(AI)與高性能計算(HPC)需求激增的驅動下持續高速增長,其中AI加速卡已成為市場增長的核心動力。據行業報告預測,全球GPU加速器市場在未來幾年將持續增長,中國市場占據重要份額且增速預計將高於全球平均水平。全球AI加速卡市場規模在2023年約為120億美元,預計到2026年將突破450億美元,其中中國市場份額預計超過30%。
市場呈現高度集中的競爭格局,由NVIDIA、AMD、Intel等國際巨頭主導。其中NVIDIA憑藉其硬體性能與CUDA軟體生態構建了顯著優勢,形成了“一家獨大、兩家追趕”的態勢。AMD正大力推廣其ROCm開放軟體平台,以吸引開發者。中國本土GPU加速器廠商也在積極發展,包括景嘉微、壁仞科技、摩爾執行緒、天數智芯、芯動科技等。部分國產加速卡產品,如海光DCU、寒武紀MLU、沐曦、燧原等,已在特定場景進行適配與套用嘗試,但在軟體生態和通用性方面與國際領先水平仍有差距。
GPU加速器的產業鏈涉及晶片設計、晶圓製造、先進封裝、高頻寬記憶體、PCB製造、散熱等多個核心環節。其中,HBM和先進封裝產能是當前全球供應鏈的關鍵瓶頸之一,直接影響高端AI加速卡的供應。行業標準如HBM4、UCIe 2.0、PCIe 7.0的演進也在持續推動產業鏈性能提升與互連標準化。
相關事件
2019年6月,英偉達宣布與Arm合作,為其生態系統提供全套AI及HPC軟體支持,旨在為未來的百億億次超級計算機打下基礎。
2024年4月,市場監管總局收到英偉達公司收購邁絡思科技有限公司股權案的經營者集中反壟斷申報。經審查,市場監管總局決定附加限制性條件批准此項經營者集中。其中,GPU加速器界定為本案相關商品市場。
向中國市場銷售英偉達GPU加速器與邁絡思高速網路互聯設備時,不得以任何方式強制進行搭售,或者附加任何其他不合理的交易條件;不得阻礙或限制客戶單獨購買或使用上述產品;不得在服務水平、價格、軟體功能等方面歧視單獨購買上述產品的客戶。
依據公平、合理、無歧視原則向中國市場繼續供應英偉達GPU加速器、邁絡思高速網路互聯設備和相關軟體、配件。
繼續保證英偉達GPU加速器與第三方網路互聯設備、邁絡思高速網路互聯設備與第三方加速器的互操作性。

