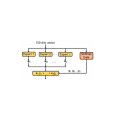
混合專家模型(Mixture of Experts,MoE)是一種神經網路架構,它通過一個門控網路(gating network)為每個輸入動態地選擇一小部分被稱為“專家”的子網路進行計算,從而以稀疏激活的方式提升模型容量與計算效率。該模型的核心理念源自1991年提出的“Adaptive Mixture of Local Experts”論文,通過訓練專家網路和門控網路實現條件計算。
MoE的核心特點在於其“高參數、低計算”的稀疏性,僅激活總參數的一小部分即可擴展模型規模,在不顯著增加浮點運算量的情況下容納更豐富的知識和更強的泛化能力,其優勢包括任務特異性、靈活性及高效性。該架構面臨負載均衡、專家間通信開銷、顯存要求高以及訓練複雜性等技術挑戰。MoE是超大規模語言模型(LLM)的重要套用架構之一,相關模型包括谷歌的GLaM、Switch Transformer,以及開源的Mixtral和DeepSeek系列模型。2025年12月,有研究機構開源了採用新稀疏性方法以替代MoE架構的Circuit Sparsity模型,該模型具有較高的權重稀疏性,採用“極致稀疏與功能解耦”思路。
MoE架構的發展與大型語言模型(LLM)緊密相關,2017年有研究將MoE層套用於循環神經網路(RNN),為後續Transformer架構套用奠定了基礎。相關研究在2020年至2021年驗證了其在大規模模型中的可行性。2022年出現了首個套用稀疏MoE的多模態模型。2023年底至2024年,有國內公司發布了採用MoE架構的大模型並進行了商業化部署探索。2024年有模型採用多層稀疏MoE架構,2025年有新一代文本大模型採用了MoE架構。2025年底至2026年初,業界陸續提出了多種採用或改進MoE架構的模型,涉及不同參數規模、模態(如視覺-語言-動作)以及醫療等特定領域。該架構的套用領域已拓展至自然語言處理、計算機視覺等多個方向。
基本介紹
- 中文名:混合專家模型
- 外文名:MoE、Mixture of experts
- 所屬學科:人工智慧
- 特點:高參數、低計算
- 核心思想:分治策略+條件計算
發展歷程
早期探索
谷歌推動
- GShard (2020): 谷歌通過GShard系統,將MoE架構擴展至擁有超過6000億參數的翻譯模型 。GShard是一套用於在超大規模計算集群上進行分散式訓練的通用系統,它引入了“專家並行”的概念,將不同的專家分布在不同的計算設備上,解決了單台設備無法容納所有專家參數的問題。
- Switch Transformer (2021): 在GShard的基礎上,谷歌提出Switch Transformer,對MoE架構進行了簡化和最佳化。採用了極度稀疏的路由策略——每次只將輸入路由到一個最合適的專家(top-1 gating)。不僅降低了計算和通信的複雜性,還有效解決了MoE訓練中的一些不穩定性問題,使得訓練過程更加高效和穩定。Switch Transformer的論文展示了其在萬億參數規模上的成功,並一度成為開源的首個基於MoE的語言模型,極大地激發了學界和業界對MoE的興趣。
開源浪潮
特點
優點
- 高參數效率: 是MoE的核心優勢,實現了模型參數規模和計算成本的有效解耦。在有限的算力下,訓練出參數量遠超以往的模型。
- 英偉達於2025年12月發布的Nemotron 3 Nano模型,採用混合MoE架構,實現了最高4倍的Token吞吐量提升,並將推理階段生成的Token數量減少最高60%,顯著降低推理成本。此外,英偉達在Nemotron 3 Super和Ultra模型中採用的NVFP4格式,進一步提升了存儲和推理效率。2025年10月,MiniMax發布並開源的新一代文本大模型M2採用MoE架構,在權威評測中位列全球前五。類似地,其他採用MoE架構的模型也展示了這一優勢,例如BU-30B-A3B-Preview模型總參數達300億,但推理時僅激活30億參數,顯著降低了對計算資源的需求。2026年1月,中科天璣發布的“社會認知大模型”採用任務級混合專家架構,在國產化全棧適配最佳化下,滿足了高並發、低延遲的實戰性能要求。同樣,科大訊飛於2026年1月攻克了MoE模型在國產算力平台上的全鏈路訓練效率難題,將其訓練效率從對標A800的30%大幅提升至93%,實現了在該領域從0到1的重大突破。2026年1月,DeepSeek V4引入的Engram模組,通過“存算分離”設計將靜態知識外掛,在等參數/等算力測試中相比純MoE模型,知識任務(MMLU、CMMLU)準確率提升3.4%-4.0%,推理任務(BBH、MATH)提升2.4%-5.0%,代碼能力(HumanEval)提升3.0%;同時記憶表可預載至主機記憶體或SSD,幾乎不增加GPU顯存壓力,降低部署成本,據稱訓練成本或可降低50%。
- 專家專業化: MoE的結構支持模型學習專門化知識。在訓練過程中,不同的專家可以自發地學會處理不同類型的數據、語言、主題或邏輯模式。 以Nemotron 3系列為例,其Nano模型專注於高效推理和邊緣設備部署,Super模型擅長多智慧型體套用,Ultra模型適用於複雜推理場景,體現了不同專家處理不同類型任務的能力。
- 更快的訓練收斂:在達到相同模型質量的情況下,MoE模型通常比同等計算量的稠密模型收斂得更快。實驗顯示訓練速度達到目標精度閾值的次數是傳統模型的一半。
挑戰
- 訓練不穩定性與負載均衡: 門控網路是MoE的“大腦”,但它的決策也可能帶來問題。一個常見的現象是“富者愈富”,即門控網路傾向於將大量輸入路由到少數幾個專家,導致這些專家過載,而其他專家則因訓練不足而“餓死”。為了解決該問題,研究者通常會引入一個額外的“負載均衡損失函式”,以激勵門控網路將輸入更均勻地分配給所有專家 。
- 高通信開銷: 在分散式訓練中,專家被分散在不同的計算節點(GPU/TPU)上。當一個節點上的輸入需要由另一個節點上的專家處理時,就必須進行跨節點的數據和參數通信。這種“All-to-All”的通信模式會成為訓練速度的瓶頸,尤其是在網路頻寬有限的情況下 。
- 推理部署複雜性: MoE在推理時計算量不大,但對記憶體(顯存)的需求高。在推理時,所有的專家參數都必須載入到記憶體中,以備隨時被門控網路調用。
- 微調難度:在微調過程中,可能會出現“專家災難性遺忘”或“專業化崩潰”等問題,需要專門的策略來維護模型的性能。
套用
技術框架
核心組件
- 專家網路(Experts): 是一組並行的、結構相同的神經網路。在Transformer中,每個專家就是一個兩層的多層感知機(MLP)。它們的結構一樣,但權重參數是獨立訓練、互不共享的。
- 門控網路(Gating Network): 是一個小型的神經網路,通常是一個簡單的線性層加上一個Softmax激活函式 。它接收來自上一層的token隱藏狀態作為輸入,輸出一個覆蓋所有專家的機率分布。這個分布表明了每個專家處理當前token的“適合度”。
- 路由策略(Routing Strategy): 門控網路輸出機率後,系統根據預設的策略選擇激活哪些專家。最常見的策略是“Top-k”,即選擇機率最高的k個專家。輸入token的向量會乘以其對應的門控權重,然後被送入選定的專家中進行計算。最後,所有被激活專家的輸出會根據門控權重加權求和,形成該MoE層的最終輸出。
關鍵系統
- GShard:GShard的核心是解決了MoE模型的並行化問題。允許將模型的不同部分“分片”到數千個加速器上。其“專家並行”策略將專家均勻分配到所有設備,而數據則在設備間根據門控決策進行動態路由。
- Switch Transformer: 將路由策略簡化為top-1,減少了計算和通信的冗餘。
- DeepSpeed-MoE: 提供了一個端到端的解決方案,覆蓋了訓練和推理的全流程 。DeepSpeed-MoE通過引入新的並行策略和高度最佳化的通信算法,降低訓練MoE模型的硬體門檻和成本。在推理方面,提供了專門的最佳化,解決MoE模型記憶體占用大的問題,讓用戶能夠部署和使用大型MoE模型。
架構創新
挑戰與未來發展
定義概念
核心思想
- 專家網路(Experts): 是一組結構相同但參數獨立的神經網路。在Transformer架構中,表現為多個並行的前饋神經網路(FFN)層 。每個專家可以被視為在某個特定領域或數據模式上具有專長的模型。
- 門控網路(Gating Network): 是一個輕量級的路由或調度網路。作用是分析輸入,然後決定將這個輸入傳送給哪些專家進行處理。門控網路會為每個專家生成一個權重或機率,得分最高的少數專家將被激活 。
稀疏激活
- 參數規模與計算量解耦: 模型的總參數量(代表其知識容量)可以持續增長,而單次推理的計算量(FLOPs)僅與被激活的專家數量有關,增長緩慢 。
- 提升模型容量:大參數量意味著模型有潛力學習到更複雜、更細緻的模式和知識,從而在各類任務上取得更好的表現。
