GLM-OCR是智譜於2026年2月3日開源的一款輕量化多模態OCR模型,參數量為0.9B。該模型對手寫體、複雜表格、代碼文檔、印章識別及多語言混排等場景進行了最佳化。
在OmniDocBench V1.5等多項文檔理解基準測試中,該模型的綜合成績為94.62分,在公式識別、表格識別、信息抽取等任務上表現較好。GLM-OCR支持通過vLLM、SGLang、Ollama、MLX等多種方式部署。模型處理PDF文檔的吞吐量為1.86頁/秒,處理圖像為0.67張/秒,支持API調用,運行所需顯存為4GB。GLM-OCR支持通用文本識別、複雜表格解析以及信息結構化提取等多種任務,採用MIT許可證開源。
基本介紹
- 外文名:GLM-OCR
- 開源機構:智譜
研發背景,發展歷程,技術特點,部署與使用,重要事件,
研發背景
GLM-OCR是由智譜AI於2026年2月開源的一款輕量級多模態OCR模型。其研發旨在解決行業中“大模型部署門檻高、小模型精度不足”的痛點問題。該模型專為複雜文檔理解而設計,針對手寫體、複雜表格、代碼文檔、印章識別及多語言混排等高難度現實業務場景進行最佳化。
發展歷程
2026年2月3日,智譜AI宣布正式發布並開源GLM-OCR模型。該模型參數規模為0.9B,支持vLLM、SGLang和Ollama部署,在公式識別、表格識別、信息抽取等多項主流基準測試中表現較好,並在OmniDocBench V1.5榜單上綜合成績靠前。
GLM-OCR
技術特點
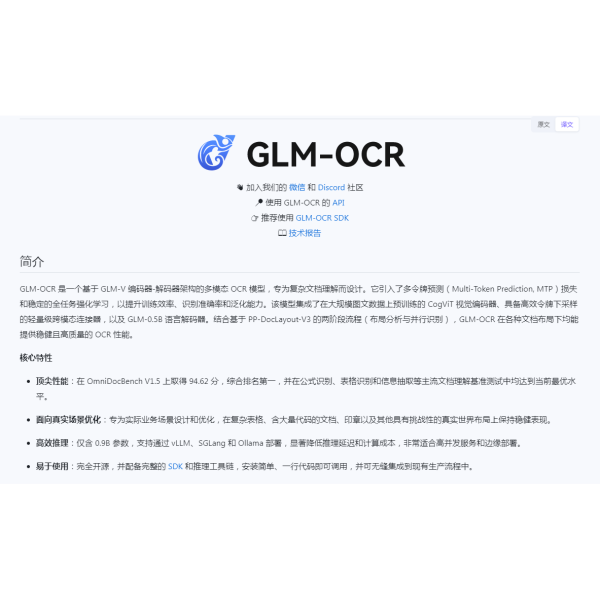
GLM-OCR是一個專為複雜文檔理解設計的輕量級多模態OCR模型,其核心特點是小參數量、高性能與高效率。模型參數量僅為0.9B,顯著降低推理延遲與算力開銷,適合高並發與邊緣部署。
GLM-OCR採用基於GLM-V的“編碼器-解碼器”架構。模型集成了自研的CogViT視覺編碼器、具有高效令牌下採樣機制的輕量級跨模態連線器,以及GLM-0.5B語言解碼器。為進一步提升性能,GLM-OCR引入了多令牌預測(MTP)損失函式和穩定的全任務強化學習機制。在技術流程上,模型採用基於PP-DocLayout-V3的“版面分析→並行識別”兩階段流程。
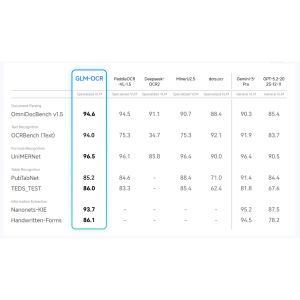
在性能表現上,GLM-OCR在OmniDocBench V1.5基準測試中以94.62分綜合排名第一。該模型在公式識別、表格識別、信息抽取等多項主流基準測試中均取得當前最優(SOTA)表現。
在效率與部署方面,GLM-OCR處理PDF文檔的吞吐量可達1.86頁/秒,處理圖像達0.67張/秒。模型支持通過vLLM、SGLang、Ollama、MLX等多種框架進行高效部署。GLM-OCR提供了完整的SDK與推理工具鏈,支持一行命令快速調用,易於集成。
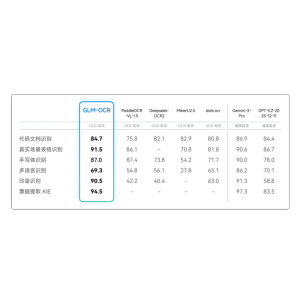
GLM-OCR針對手寫體、複雜表格(如合併單元格、多層表頭)、代碼文檔、印章識別及多語言混排等高難度現實場景進行了專門最佳化。模型支持通用文本識別、複雜表格解析(可輸出HTML)以及信息結構化提取(可輸出JSON)等多種任務。GLM-OCR模型以MIT許可證開源,其完整的OCR流程集成了用於文檔版面分析的PP-DocLayoutV3,後者採用Apache License 2.0許可證。
部署與使用
GLM-OCR支持多種部署框架,包括vLLM、SGLang、Ollama和MLX(Apple Silicon)。
模型提供完整的SDK與推理工具鏈,支持一行代碼調用,使用方式包括從ModelScope下載與推理、通過GLM-OCR SDK推理(便捷函式或類接口)、CLI命令行以及Flask Web服務部署。
GLM-OCR支持通過ms-swift進行模型微調,並提供了示例腳本。
GLM-OCR支持API調用,最低僅需4GB顯存即可運行,兼容消費級GPU與邊緣設備,支持私有化本地部署。
GLM-OCR模型以MIT許可證開源,其集成的PP-DocLayoutV3採用Apache License 2.0許可證。
重要事件
2026年2月3日,智譜宣布正式發布並開源GLM-OCR。該模型參數量僅0.9B,支持vLLM、SGLang和Ollama等主流推理框架部署,在公式識別、表格識別、信息抽取等多項主流基準測試中進行了性能評估。
此次發布正值2025年以來OCR成為大模型廠商布局的重點方向,GLM-OCR與DeepseekOCR、HunyuanOCR等產品一同代表了這一行業趨勢。
