SkyReels-V1是中國崑崙萬維公司於2025年2月開源的首個面向AI短劇創作的視頻生成模型,旨在通過自動化內容生成技術推動短劇生產革新。該模型基於海量好萊塢級影視數據訓練,可生成包含電影級光影美學與構圖的視頻內容,支持文生視頻與圖生視頻雙模態輸入,在開源圖生視頻模型中參數規模最大。
該模型通過自研算法框架實現了影視級人物動態生成,支持33種微表情與400餘種自然動作的精準控制,並配套開源表情動作算法SkyReels-A1強化肢體與表情的協同性。技術上採用分散式並行運算與顯存最佳化方案,單台NVIDIA 4090顯示卡可在80秒生成544p解析度視頻,同時兼容低配置設備部署。其架構整合了注意力機制最佳化、模型編譯加速及開源diffuser庫適配等技術,形成從數據清洗到推理最佳化的完整技術體系。
基本介紹
- 軟體名稱:SkyReels-V1
- 出品公司:崑崙萬維
發展歷程,主要功能,
發展歷程
2025年2月18日,崑崙萬維開源中國首個面向AI短劇創作的視頻生成模型SkyReels-V1。
主要功能
SkyReels-V1 針對表演細節做了打標,還對情緒、場景、表演訴求等進行處理,利用“千萬級別、高質量”的好萊塢級別數據進行訓練微調。
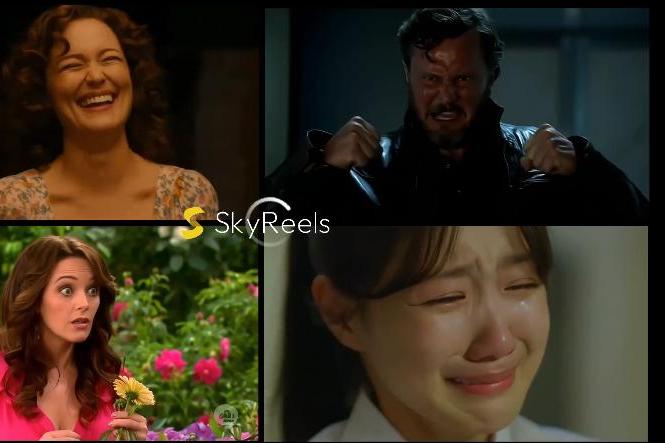
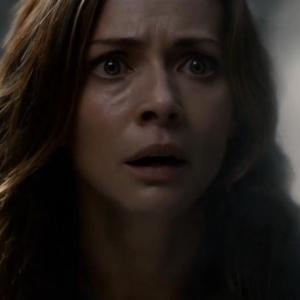
SkyReels-V1 可實現“影視級人物微表情表演生成”,支持 33 種人物表情與 400 + 種自然動作組合,還原真人情感表達,支持生成大笑、怒吼、驚訝、哭泣等微表情。
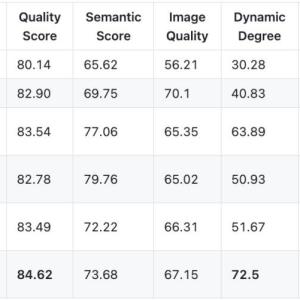
SkyReels-V1 不僅支持文生視頻,還支持圖生視頻,號稱是“開源視頻生成模型中參數最大的支持圖生視頻的模型”,在同等解析度下各項指標實現開源 SOTA。
總結來看,SkyReels-V1 可以實現:
- 影視化表情識別體系:11 種針對影視戲劇中的人物表情理解,如不屑、不耐煩、無助、厭惡等表情的理解;
- 人物空間位置感知:基於人體三維重建技術,實現對視頻中多人的空間相對關係理解,助力模型生成影視級人物站位;
- 行為意圖理解:構建超過 400 種行為語義單元,實現對人物行為的精準理解;
- 表演場景理解:實現人物-服裝-場景-劇情的關聯分析。
性能方面,在自研推理最佳化框架「SkyReels-Infer」的加持下,該模型可實現 544p 解析度,推理基於單台 4090 用時 80s,還支持分散式多卡並行,支持 Context Parallel,CFG Parallel,和 VAE Parallel。
此外,模型採取 fp8 quantization 以及 parameter-level offload,滿足低顯存用戶級顯示卡運行需求;支持 flash attention、SageAttention,模型編譯最佳化等,進一步最佳化延遲;基於開源 diffuser 庫,提升易用性。
為了實現更加精準可控的人物視頻生成,崑崙萬維還開源了 SOTA 級別的基於視頻基座模型的表情動作可控算法 SkyReels-A1,對標 Runway 的 Act-One,SkyReels-A1 支持視頻驅動的電影級表情捕捉。
SkyReels-A1 能夠基於任意人體比例(包括肖像、半身及全身構圖)生成人物動態視頻。
SkyReels-V1
