MinerU是由上海人工智慧實驗室OpenDataLab團隊在2024年7月4日世界人工智慧大會(WAIC)科學前沿主論壇上開源的智慧型數據提取工具,旨在解決複雜多模態文檔處理難題,提升AI語料準備效率,並通過與RAG技術結合,助力法律、財務、學術等垂直領域構建新知識引擎。該工具分為Magic-PDF與Magic-Doc兩大組件,其中Magic-PDF可識別PDF文檔中的圖文、表格、公式等元素並轉化為Markdown或Latex格式,支持掃描版及亂碼PDF處理;Magic-Doc專注於網頁干擾信息過濾與正式內容提取,同時支持docx等格式批量轉換。
基本介紹
- 軟體名稱:MinerU
- 開發商:上海AI實驗室
產生背景,發展歷程,主要功能,
產生背景
在這個信息爆炸的時代,AI研究者常常面臨著從大量文檔中提取高質量數據的挑戰。無論是學術文獻、行業報告、會議PPT、課本、說明書還是契約單據,這些文檔往往以PDF或網頁的形式存在,內容複雜,格式多樣,給AI語料的快速、精準提取帶來了不小的難度。
發展歷程
在2024年7月4日舉行的WAIC 2024科學前沿主論壇上,在數據處理環節,上海人工智慧實驗室(上海AI實驗室)大模型數據基座OpenDataLab團隊開源了全新的智慧型數據提取工具——MinerU。
主要功能
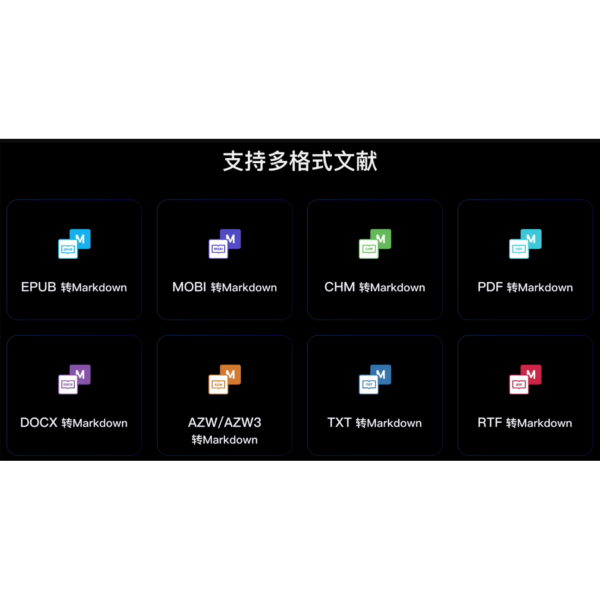
MinerU,作為一款全能、開源的文檔與網頁數據提取工具,致力於簡化開發者的數據處理流程。它不僅能將混合了圖片、表格、公式等在內的多模態PDF文檔精準轉化為清晰、易於分析的Markdown格式;還能從包含廣告等各種干擾信息的網頁中快速解析、抽取正式內容;同時支持docx等多種格式批量轉化為Markdown……
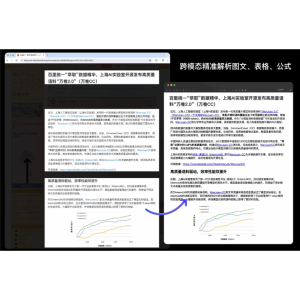
MinerU 由2個部分組成,Magic-PDF( PDF文檔提取)、Magic-Doc(網頁提取)。分別提供不同功能:01快速識別與轉換MinerU中的Magic-PDF能夠快速識別PDF版面元素,自動刪除頁眉、頁腳、腳註等非正文內容,保留原文檔的結構和格式,包括標題、段落、列表等,準確提取圖片、表格和公式等多模態內容,並根據順序,將文檔轉化為清晰、通順、易讀的Markdown格式。
在OpenDataLab自研的公式識別模型加持下,Magic-PDF也能輕鬆地將其轉化為Latex格式。另外亂碼PDF、掃描版PDF等也能自動識別並轉換……
MinerU
