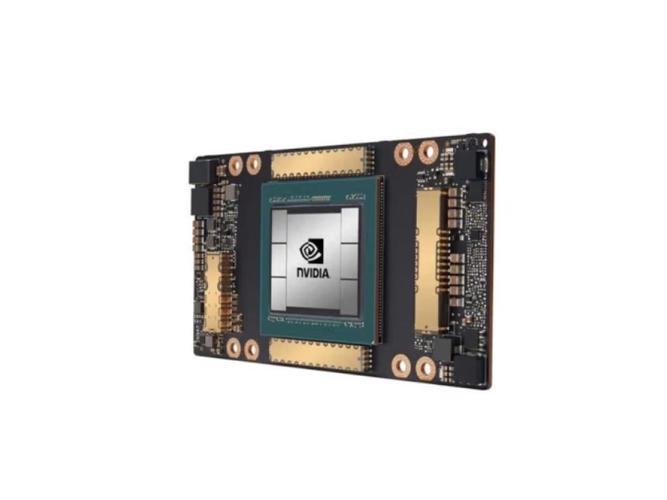
H100/H200是英偉達(NVIDIA)公司推出的兩代基於Hopper架構的高性能數據中心GPU,專為人工智慧(AI)訓練與推理、高性能計算(HPC)及數據分析工作負載設計。
H100率先發布,採用台積電4N工藝,集成了超過800億個電晶體。其核心創新包括專用的Transformer引擎、第四代Tensor Core以及對FP8精度的支持,旨在加速大型語言模型(LLM)訓練。它通過第四代NVLink提供高達900 GB/s的GPU間互聯頻寬。
H200是H100的疊代升級產品,於2023年11月發布。它是首款採用HBM3e記憶體的GPU,將顯存容量提升至141GB,頻寬達到4.8 TB/s,能夠支持Llama 2等大語言模型的推理任務。
這兩款GPU是英偉達在AI計算領域的重要硬體產品,被套用於雲伺服器、超級計算機及AI算力集群。
基本介紹
- 中文名:H100/H200
- 產品類型:AI GPU
- 上市時間:2022年3月、2023年11月
產品簡介,核心技術,規格解析,AI訓練與推理性能,高性能計算性能,系統產品,相關事件,
產品簡介
H100與H200是英偉達(NVIDIA)基於Hopper架構的兩代高性能數據中心GPU,旨在為人工智慧(AI)訓練與推理、高性能計算(HPC)及數據分析提供強大的算力支持。
H100於2022年3月發布,是基於Hopper架構的首款產品。H100引入了Transformer引擎、第四代Tensor Core、第四代NVLink和PCIe Gen5等關鍵技術,主要套用於加速大型語言模型(LLM)訓練、推理及HPC工作負載。
H200於2023年11月發布,作為H100的升級款,其核心計算單元規格基本一致。H200的主要升級在於採用了HBM3e記憶體,顯存容量和頻寬大幅提升。這一升級旨在更好地處理大規模生成式AI和HPC工作負載,特別是在大語言模型推理任務上,性能相比H100有顯著提升。
核心技術
H100與H200 GPU均基於英偉達的Hopper™ GPU架構,採用台積電4N工藝製造,擁有超過800億個電晶體。其核心創新之一是專用的Transformer Engine,它結合第四代Tensor Core,可動態選擇FP8/FP16精度,在不損失模型精度的前提下,大幅加速基於Transformer架構的大語言模型(LLM)訓練與推理。在互連方面,支持第四代NVLink技術,提供高達900GB/s的GPU間雙向互連頻寬,並支持PCIe Gen 5.0接口。Hopper架構引入了DPX指令集,專門用於加速動態規划算法,其性能相比前代Ampere架構的A100 GPU提升最高可達7倍。該系列GPU支持多實例GPU(MIG)技術,可將單個物理GPU劃分為多個獨立、安全的GPU實例,提高數據中心資源利用率和多租戶部署的靈活性。Hopper架構內置了機密計算(Confidential Computing)安全功能,可在硬體和管理程式級別保護數據和應用程式的機密性與完整性。
規格解析
H100主要型號包括SXM5版(如H100 SXM5 80GB/94GB)和PCIe版(如H100 PCIe 80GB/94GB/NVL),而H200主要型號包括HGX H200(4或8 GPU配置)和MGX H200 NVL。H100配備80GB或94GB HBM3記憶體,記憶體頻寬為每秒3.35TB或3.9TB,其SXM版本最大熱設計功耗高達700W,PCIe版為350-400W。H200是第一款搭載141GB HBM3e記憶體的GPU,記憶體頻寬為每秒4.8TB,最大熱設計功耗最高為700W(HGX配置)或600W(NVL配置)。兩者均基於台積電4N工藝製造,擁有超過800億個電晶體,並支持第四代NVLink(高達900 GB/s GPU至GPU頻寬)和PCIe Gen5(128 GB/s)互連技術。
AI訓練與推理性能
H100基於NVIDIA Hopper架構構建,配備專用的Transformer引擎和第四代Tensor Core,在大型語言模型(如GPT-3 175B)訓練上相比前代A100提速最高可達30倍,推理提速最高30倍。H200與H100基於相同的Hopper架構,核心計算單元規格相近,FP8算力相近,其主要升級在於更大更快的記憶體(HBM3e)。H200針對大模型推理最佳化,在處理Llama2 70B等模型時,推理速度比H100提升最高約2倍,在處理GPT-3 175B模型推理時,速度相比H100提升約1.6倍。
高性能計算性能
在HPC套用方面,H100性能相比A100提升最高7倍,這得益於其增強的FP64算力。H200憑藉更高的記憶體頻寬,在模擬、科學研究等記憶體密集型HPC套用中,相比H100有超過20%的性能提升。
系統產品
基於H100/H200 GPU,英偉達推出了多種系統級產品,包括DGX H100/H200、HGX H100/H200以及SuperPOD超算集群,共同構建了高性能AI計算基礎設施。
DGX H100是第四代AI專用系統,集成8個H100 GPU,通過NVLink(提供每秒900 GB的GPU至GPU雙向頻寬)和NVSwitch(每秒7.2TB的GPU雙向頻寬)實現高速互聯,是AI基礎設施的參考設計。DGX H100系統擁有640GB總GPU記憶體,並配備了8個NVIDIA ConnectX-7和2個BlueField-3 DPU,提供高速網路連線。
HGX H100/H200是英偉達為合作夥伴伺服器提供的基板設計。例如,ASUS ESC N8-E11是一款7U規格的NVIDIA HGX H100/H200八-GPU伺服器,支持雙路第五代Intel Xeon可擴展處理器,適用於大規模AI和HPC工作負載。
DGX/HGX系統可通過NVLink Switch系統擴展成由數百個GPU組成的超大規模集群,例如DGX SuperPOD。配備NVLink Switch系統的DGX GH200系統支持由多達256個相互連線的H200組成的集群,同時提供57.6 TB/s的all-to-all頻寬,用於百億億次(Exascale)級別的高性能計算與AI訓練。
H200 GPU與支持H100的HGX等伺服器平台兼容,便於用戶在原位進行升級,雲服務提供商在添加H200時無需進行任何更改。
相關事件
2025年底至2026年初,英偉達執行長黃仁勛在GTC 2026大會上證實,公司已獲得向多家中國客戶銷售H200的許可,並已重啟相關生產與供應鏈。
中國市場對H200存在強勁需求,例如中國科技公司自2026年以來的下單需求已超過200萬顆。但實際交易受美國政策審批與供應能力的嚴格限制。
H200的對華出口被視為美國在維持AI技術領先優勢與獲取經濟收益之間的一種策略平衡。英偉達執行長黃仁勛曾公開表示,人工智慧並非核武器,而是各國都應掌握的基礎技術。
