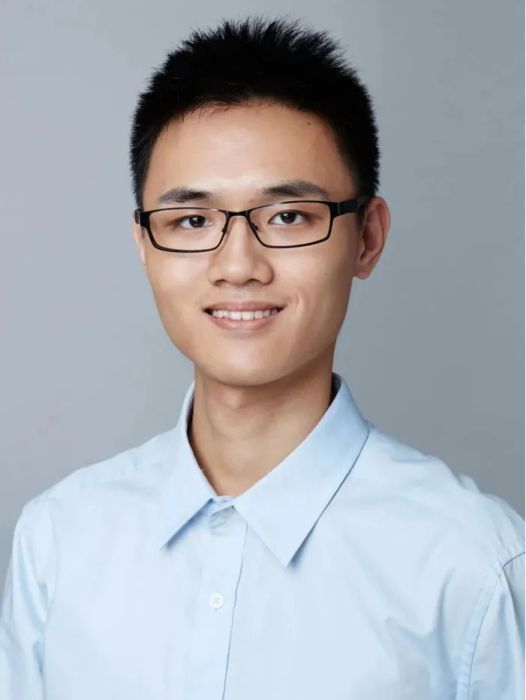
林俊暘(Junyang Lin),1993年3月19日出生,北京大學計算機科學本科、語言學碩士,現任阿里巴巴集團通義千問大模型負責人,系阿里巴巴最年輕P10級技術專家。研究領域涵蓋自然語言處理與多模態表示學習,在NeurIPS、ICML、ACL等頂級會議發表多篇論文。
2019年入職阿里巴巴達摩院後,參與超大規模預訓練模型M6及通用統一多模態預訓練模型OFA開發。2022年主導完成Chinese CLIP中文預訓練模型。2023年推動通義千問大模型發布,其底層架構整合多模態技術成果。2024年主導Qwen系列模型開源工作,涉及7B、14B、72B等不同參數規模版本,其中72B模型曾獲LMSYS chatbot Arena人工評測開源榜首。同年因Qwen項目代碼被GitHub誤標下架事件作出公開回應。2025年推出旗艦模型Qwen3-Max,參數規模超萬億並採用36T預訓練數據,在GPQA等評測中超越同期國際主流模型。同年組建機器人與具身智慧型研究團隊,推動多模態智慧型體向現實世界套用延伸。2026年在AGI-Next前沿峰會提出"模型即產品"觀點,強調基礎模型需與真實物理世界互動。
基本介紹
人物經歷,主要貢獻,人物事件,
人物經歷
2019年畢業後,林俊暘徑直加入阿里巴巴達摩院,正式開啟職業生涯,擔任高級算法工程師。
2020年,OpenAI發布GPT-3引發全球熱議後,阿里巴巴迅速啟動內部大模型研發的“賽馬機制”,同步推進兩條技術路線:主攻文本的AliceMind,以及側重多模態融合的M6。憑藉“語言學+技術”的複合背景,林俊暘被分配至周靖人領導的智慧型計算實驗室,成為M6模型團隊的核心開發者。
2022年,阿里啟動AI資源整合,AliceMind團隊在內部賽馬中出局,M6技術路線被正式確立為集團通用大模型的核心方向。憑藉在模型架構設計與工程落地中的突出表現,林俊暘在阿里實現了快速晉升,從核心開發者升任項目主管,主導研發了通用統一多模態預訓練模型OFA(One-For-All,一體化多模態預訓練框架)與中文預訓練模型Chinese CLIP(中文視覺-文本匹配模型),進一步強化了阿里在多模態領域的技術壁壘。
2022年底,阿里巴巴將達摩院的語言、視覺等AI團隊整體併入阿里雲,成立通義實驗室。林俊暘被正式任命為通義千問系列大模型的技術負責人,全面負責核心模型研發與戰略規劃。
2025年10月8日,阿里Qwen團隊核心負責人林俊暘在社交媒體上發布了一條簡短動態:“已在Qwen內部親手組建機器人與具身智慧型小組。”
林俊暘照片
主要貢獻
Qwen3系列開源模型
2023年4月,阿里雲正式發布“通義千問”。其底層架構融合了林俊暘主導最佳化的多模態技術,這也是他在阿里多年來研究積累的成果。但他並未滿足於此。兩年後,在他的推動下,阿里推出Qwen3系列開源模型。旗艦版本Qwen3-Max擁有超萬億參數和36T預訓練數據,在GPQA、LiveCodeBench等權威評測中超越GPT-5、Claude Opus 4,躋身全球前三。林俊暘在社交平台上寫道,團隊為此花費近一年時間,攻克了三項核心難題:“讓強化學習框架能穩定支撐長時序推理,平衡跨領域數據分布以避免模型偏科,並強化多語言能力以服務全球開發者。”
人物事件
Qwen項目代碼因誤標被GitHub“下架”
真正讓外界認識林俊暘的,是2024年的通義千問(Qwen)。那一年,隨著多版本模型相繼開源、阿里內部AI團隊的重組,以及GitHub風波引發的輿論關注,這位原本低調的技術負責人突然站到了聚光燈下。當Qwen項目代碼因誤標被GitHub“下架”引發外界質疑時,林俊暘親自出面回應:“團隊沒有跑路,我們還在,只是組織賬號被誤標記。”[
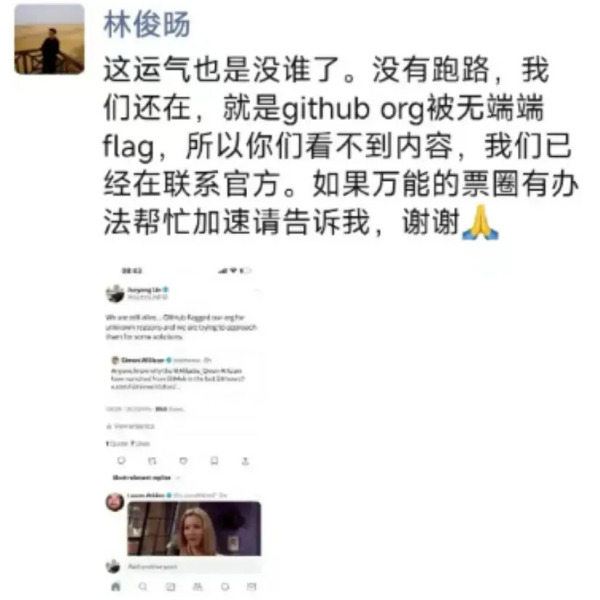
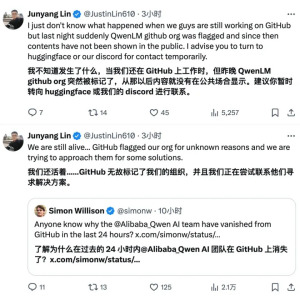
林俊暘回應“阿里Qwen的GitHub網頁404”
