Qwen3-Next-80B-A3B是阿里雲通義團隊於2025年9月12日發布的下一代基礎模型架構Qwen3-Next系列模型,包含Instruct(指令執行)與Thinking(推理思考)兩個開源版本。
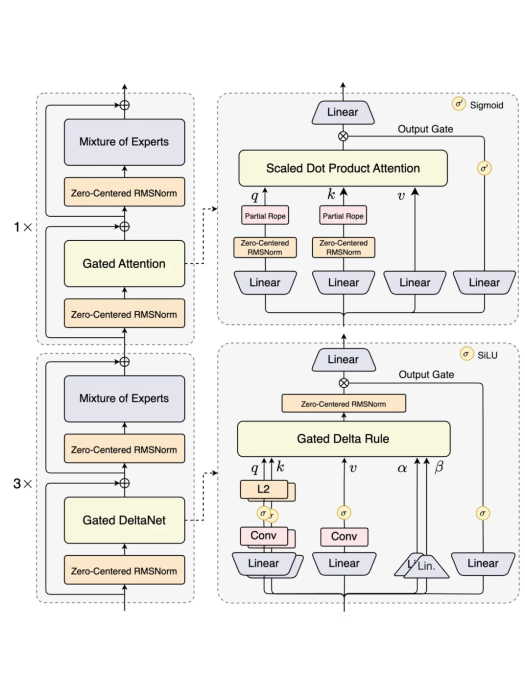
該模型採用超稀疏混合專家(MoE)架構,總參數80億個,推理時每Token僅激活30億參數,通過512個專家網路中選擇10個路由專家加1個共享專家實現參數高效激活。模型整合Gated DeltaNet線性注意力與Gated Attention門控注意力的混合注意力機制,其中75%層採用線性注意力提升長文本處理效率,25%層保留標準注意力保證信息召回精度。
採用多Token預測(MTP)技術提升預訓練效率,支持原生26萬tokens上下文長度並可通過YaRN擴展至百萬級。適配NVIDIA Hopper與Blackwell平台,通過SGLang、vLLM框架實現高並發部署。
與Qwen3-32B相比,訓練成本降低90%,32K以上長文本推理吞吐量提升10倍以上,Instruct版本性能接近Qwen3-235B旗艦模型,Thinking版本在數學推理等任務中超越Gemini-2.5-Flash-Thinking。
基本介紹
- 中文名:Qwen3-Next-80B-A3B
- 上市時間:2025年9月12日
產品沿革,規格參數,
產品沿革
2025年9月12日,阿里雲通義團隊宣布推出其下一代基礎模型架構 Qwen3-Next,並開源了基於該架構的 Qwen3-Next-80B-A3B 系列模型(Instruct 與 Thinking)。
規格參數
該模型擁有 800 億參數(僅激活 30 億參數)、3B 激活的超稀疏 MoE 架構(512 專家,路由 10 個 + 1 共享),結合 Hybrid Attention(Gated DeltaNet + Gated Attention)與多 Token 預測(MTP)。
