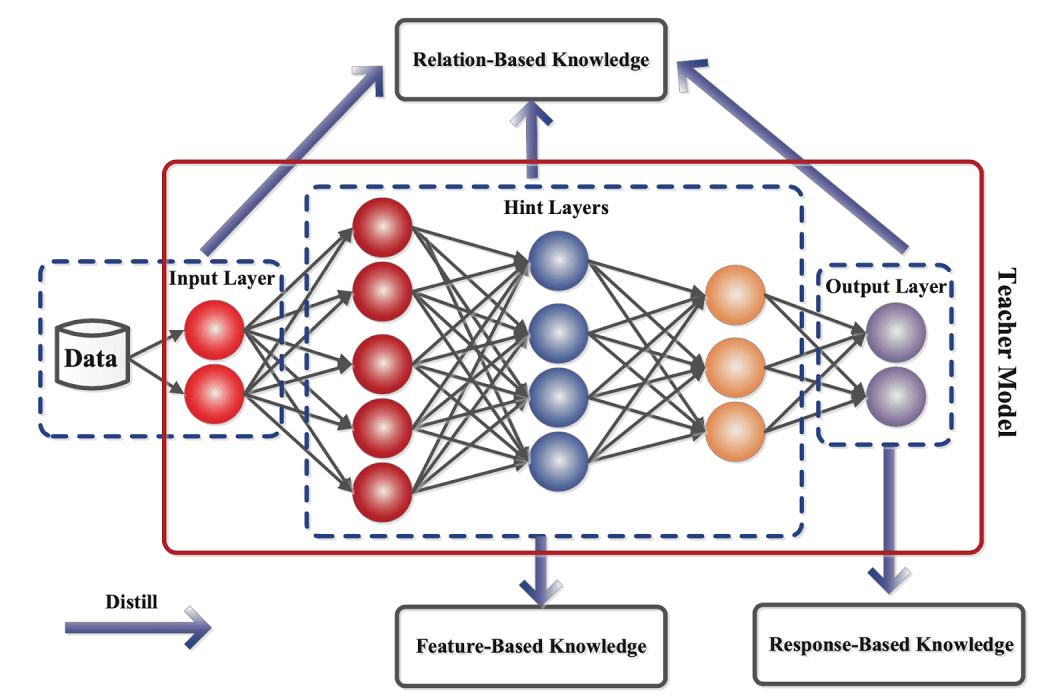
知識蒸餾是一種機器學習模型壓縮方法,旨在將大型模型的知識遷移到小型模型中,以提高模型性能和泛化能力。知識蒸餾的核心思想是將複雜模型的知識轉化為更精簡、更有效的表示,使其在保持高性能的同時,降低計算複雜度和資源需求。作為一種先進的機器學習技術,其核心理念在於將一個複雜、龐大的模型(通常稱為教師模型)的知識和經驗,提煉並“灌輸”給一個更小、更簡單的模型(學生模型)。這一過程不僅能夠保留教師模型的預測能力和準確性,同時還能顯著提升學生模型的運行效率和計算性能,使其在資源受限的環境下也能表現出色。
基本介紹
- 中文名:知識蒸餾
- 外文名:Knowledge Distillation
- 其它名稱:模型蒸餾
- 適用模型:Teacher—Student模型
基本原理,技術詳解,①教師模型訓練,②學生模型訓練,
基本原理
與傳統的預訓練不同,“知識蒸餾技術”是使用一個大型的“教師模型(Teacher Model)”來指導一個小型的“學生模型(Student Model)”的訓練。用“蒸餾”方式訓練小模型,不再直接從訓練大模型時會用到的那些巨量數據中學習,而只是在模仿。教師模型就是壓縮前的AI大模型,學生模型即壓縮之後的模型,並往往是一個新建的模型。蒸餾過程中,將對教師模型和學生模型輸入相同的token,並引導學生模型的最終輸出內容趨同於教師模型的最終輸出內容。
“知識蒸餾技術”目的是在保留模型性能的前提下,將複雜的、大體量的AI大模型,壓縮成為體量相對較小的AI模型。從而減少企業部署AI模型的成本,提高模型的推理效率。
技術詳解
具體來說,知識蒸餾使用的是Teacher—Student模型,其中teacher是“知識”的輸出者,student是“知識”的接受者。知識蒸餾的過程分為2個階段:
①教師模型訓練
訓練"Teacher模型", 簡稱為 Net-T,它的特點是模型相對複雜,也可以由多個分別訓練的模型集成而成。對"Teacher模型"不作任何關於模型架構、參數量、是否集成方面的限制,因為該模型不需要部署,唯一的要求就是,對於輸入X, 其都能輸出Y,其中Y經過softmax的映射,輸出值對應相應類別的機率值。
②學生模型訓練
訓練"Student模型", 簡稱為Net-S,它是參數量較小、模型結構相對簡單的單模型。同樣,對於輸入X,其都能輸出Y,Y 經過softmax映射後能輸出相應類別的機率值。

由於使用softmax的網路的結果很容易走向極端,即某一類的置信度超高,其他類的置信度都很低,此時學生模型關注到的正類信息可能還是僅屬於某一類。除此之外,因為不同類別的負類信息也有相對的重要性,所有負類分數都差不多也不好,達不到知識蒸餾的目的。為了解決這個問題,引入溫度(Temperature)的概念,使用高溫將小機率值所攜帶的信息蒸餾出來。具體來說,在logits過softmax函式前除以溫度T。
在小模型訓練好後的預測環節,就不需要再有溫度T,直接按照常規的Softmax輸出即可。
