基本介紹
- 中文名:張量並行
- 別名:層內模型並行
主要成就,實現方式,優缺點,套用實踐,主要作品,軟體實現,
主要成就
張量並行的主要成就在於其作為一項關鍵的分散式訓練技術,有效解決了大規模語言模型訓練中的記憶體瓶頸問題。該技術使得訓練參數規模達數十億乃至萬億的模型成為可能,並與數據並行、流水線並行共同構成了現代大規模分散式訓練的基石。
2019年,Megatron-LM論文首次提出了張量並行技術。研究者利用該技術成功訓練了包含83億參數的模型,驗證了其可行性。這項工作被視為AI基礎設施領域的一項重要工作。Megatron-LM開源庫隨後在相關領域得到套用。
實現方式
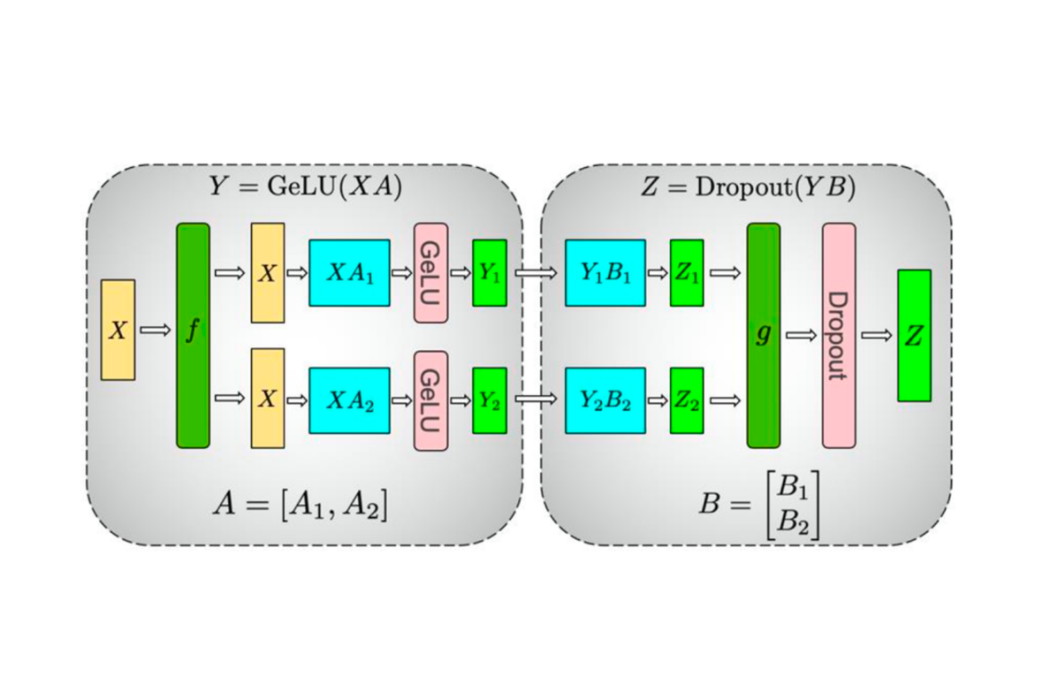
張量並行主要通過將網路層中的權重矩陣或張量切分到多個計算設備上來實現。常見的參數切分方式包括按行切分(Rowwise)和按列切分(Colwise)。以矩陣乘法為例,若原始矩陣維度為M×N,按行切分後,各個設備上的矩陣維度為M/K×N(K為設備數量);按列切分後,維度為M×N/K。
在Transformer模型的具體實現中,張量並行被套用於多個核心組件。Embedding層的參數被均勻切分到多個設備上,對於輸入索引,每個設備檢查其是否在自己的邏輯索引範圍內,若在則返回對應表項,否則返回全零虛擬表項,最終通過AllReduce操作匯總得到完整的Embedding向量。Attention組件中用於計算注意力分數的Q、K、V等大型矩陣可以按行或按列切分到不同設備上進行並行計算,再通過通信操作匯總結果。MLP組件同樣包含大量的矩陣乘法操作,可通過類似的矩陣切分實現並行。
實現張量並行需保證節點間高效的通信效率,否則通信開銷將成為性能瓶頸。需要合理劃分數據集並確保各計算設備間的負載均衡,以避免訓練結果不穩定。還需注意Transformer模型中如Dropout等隨機性操作在並行環境下的控制。
除了基本的行列切分,張量並行還包括更細化的並行風格,例如序列並行(Sequence Parallelism)。序列並行主要用於處理如LayerNorm、Dropout等操作,它通過複製模組參數並在序列維度上對輸入進行分片計算來實現。
優缺點
張量並行的優點在於可以實現高度的並行化,提高訓練效率。由於每個節點處理一部分參數,可以降低記憶體占用,緩解記憶體瓶頸問題。張量並行還可以利用多機多卡環境進行訓練。
張量並行需要保證節點間的通信效率,否則會嚴重影響訓練速度。它面臨通信開銷大、設備間同步複雜的挑戰。需要保證數據集的劃分方式和節點間的負載均衡,否則會導致訓練結果的不穩定。Tensor Parallelism APIs是實驗性的,可能變化。
如果計算資源充足且節點間通信效率較高,張量並行是一種有效的訓練策略。張量並行能與其他並行策略結合。如果計算資源有限或者節點間通信存在瓶頸,可能需要考慮其他的並行策略。
套用實踐
在實際套用中,張量並行常與數據並行和流水並行結合使用,以實現更高效的大規模模型訓練。例如,Megatron-LM是一個支持超大規模Transformer模型訓練的開源項目,它採用了數據並行+模型並行+流水並行的方式,在數千張GPU上實現了萬億級參數的模型訓練。
為了更好地利用張量並行進行大模型分散式訓練,建議選擇合適的切分方式和合併方式。需要保證節點間的通信效率,可以通過使用高性能網路或者最佳化通信協定等方式來實現。同時要保證數據集的劃分方式和節點間的負載均衡。在訓練過程中監控各個節點的訓練狀態和性能指標。可以結合其他最佳化技術如梯度累積等來進一步提高訓練效率和模型性能。為了應對通信開銷大、設備間同步複雜等挑戰,可以採用一些最佳化策略,如減少通信次數、最佳化通信模式、使用高效的通信庫等。
張量並行是一種非常重要的分散式訓練策略,通過合理的配置和使用,可以有效地提高大模型訓練的效率和穩定性。張量模型並行作為一種高效的並行計算技術,在Transformer模型的大規模訓練中發揮著重要作用,通過合理利用計算資源和通信策略,顯著提升了大規模模型的訓練速度和效率。
主要作品
2019年,研究者通過《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》論文提出並驗證了張量並行(層內模型並行)技術。該工作成功訓練了當時前所未有的83億參數語言模型,證明了該技術的可行性。其實現方式較為簡潔,並能與其他並行策略結合。其開源的Megatron-LM庫迅速成為行業標準,為訓練千億乃至萬億參數模型提供了關鍵的工程藍圖。該技術與數據並行、流水線並行共同構成了現代大規模分散式訓練的基石。
軟體實現
PyTorch通過模組提供了張量並行的官方API支持。其入口點是函式,用戶通過指定來並行化模型。
該API支持多種並行風格:(列並行)和(行並行)適用於和模組;(序列並行)適用於、等模組。用戶可以通過和來配置張量的分散式布局。並行化的交叉熵損失計算可通過上下文管理器實現。該API目前處於實驗階段,未來可能發生變化。
