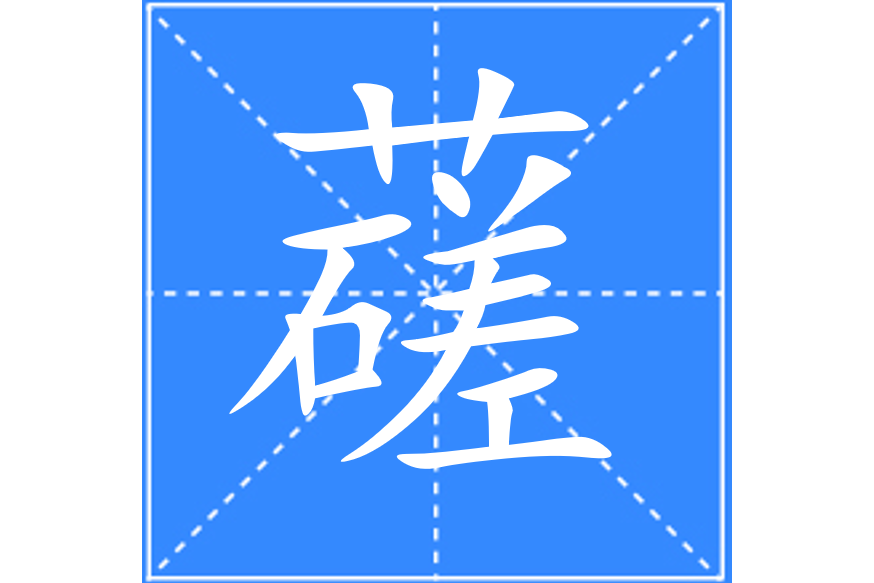
䕢是漢語通用規範漢字,拼音為zhǎ(注音ㄓㄚˇ),字形結構為上下組合的形聲字,由"艹"部首與其他部件構成。根據《康熙字典》記載,該字總筆畫數為17畫,歸入"申集上"艸部。基本釋義為"不中貌",常與"藞"字組合成"藞䕢"一詞使用,該釋義源自《集韻》《玉篇》等古籍。現代漢字編碼體系中,其五筆輸入法代碼為ADUA,統一碼為U+4562。
基本介紹
- 拼音:zhǎ
- 部首:艹
- 總筆畫:17
- 五筆編碼:ADUA
- 統一碼:4562
- 鄭碼:EGUB
字形結構,字音解析,字義探源,編碼體系,古籍記載,組詞套用,詳細釋義,
字形結構
由"艸"部(草字頭)與下部構件組成上下結構,總筆畫數為17畫,屬形聲字造字法。四角號碼標註為44612,字形筆順遵循漢字書寫規範中的"從左到右,從上到下"基本原則。
字音解析
在傳統音韻體系中:
- 《集韻》標註反切注音為"竹下切"
- 《詞林正韻》歸入二十二禡韻部
- 現代國語讀音為zhǎ(ㄓㄚˇ)
音序對應關係顯示其與"𦅁"字讀音相同,國語羅馬字拼音系統注音為zha。
字義探源
"䕢"本義為"不中貌",該釋義最早見於《玉篇》"藞䕢"條目。根據古籍註解:
- "不中"指不符合標準或要求
- "貌"在此處表示事物的狀態特徵
該釋義在《漢語大字典》中沿用至今,現代引申義可涵蓋'粗劣''虛弱'等概念。
編碼體系
在計算機字元編碼標準中:
- 五筆輸入法編碼:ADUA(A對應艹部,D對應大字頭,U對應並字底,A為末筆識別碼)
- 鄭碼輸入法編碼:EGUB
- 統一碼(Unicode)十六進制編碼:U+4562
- 區位碼系統未收錄該字
古籍記載
《康熙字典》收錄該字的主要信息:
- 出處:《申集上·艸部》
- 頁碼定位:1065頁第43字
- 注音引證:"竹下切,音𦅁"
- 釋義關聯:"《玉篇》藞䕢,見藞字注"
相關典籍系統性地建立了該字的形音義對應關係。
組詞套用
現存文獻中主要出現在複合詞"藞䕢"中,該詞具有以下特徵:
- 結構類型:疊韻聯綿詞
- 使用範疇:古代書面用語
- 語法功能:形容詞性短語
現代漢語國語中已非常用辭彙,主要保留在古籍文獻及專業辭書中。
詳細釋義
拼音 | 釋義 | 例詞 |
|---|---|---|
zhǎ | 見“藞”,不中貌 | 藞䕢 |
(參考資料:)
